
El congreso PSD 2026 en Cádiz reúne a expertos en privacidad de 19 países
La duodécima edición del congreso PSD 2026 en Cádiz aborda en la Universidad el uso seguro de datos, la inteligencia artificial y el riesgo de divulgación de información
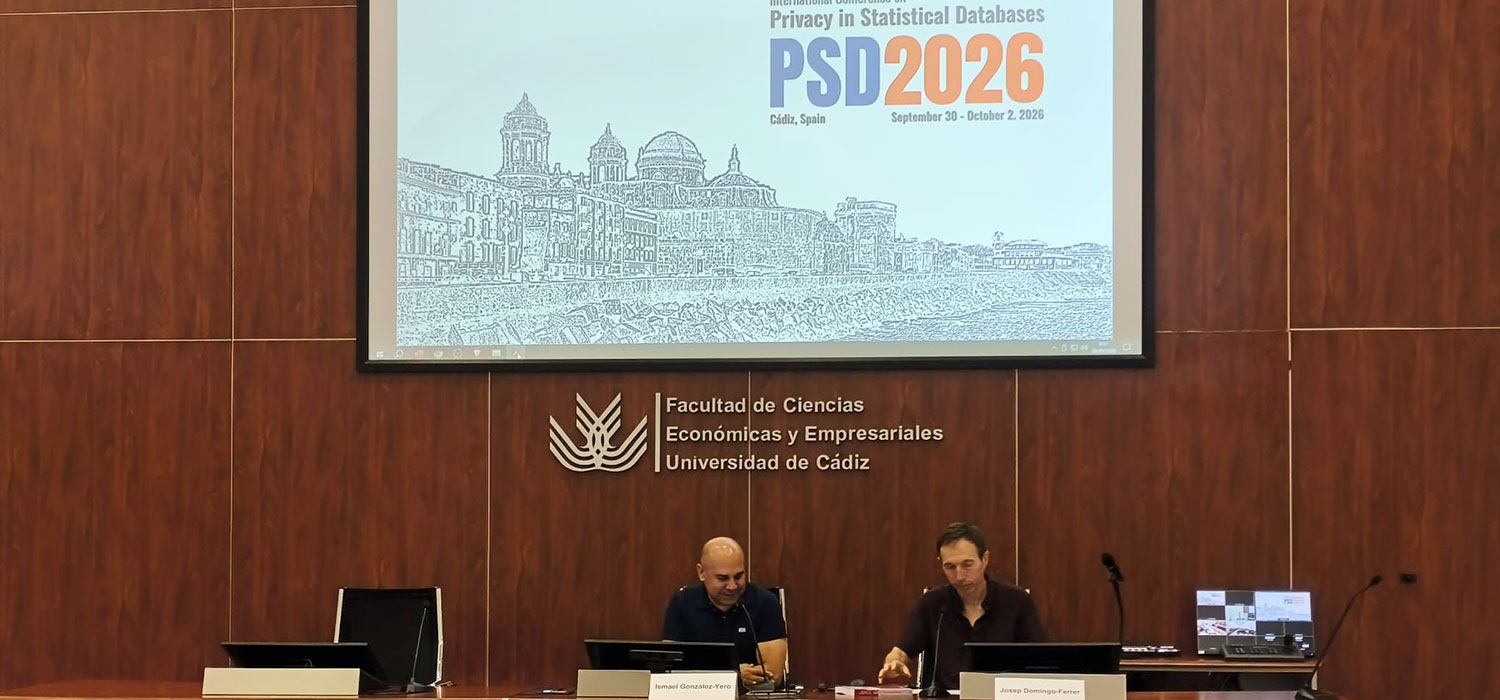
La Facultad de Ciencias Económicas y Empresariales de la Universidad de Cádiz ha acogido la duodécima edición de Privacy in Statistical Databases, un encuentro internacional centrado en la privacidad y la protección de datos. El congreso PSD 2026 en Cádiz ha reunido trabajos de especialistas de 19 países de los cinco continentes.
Investigadores, profesionales y representantes de organismos estadísticos nacionales e internacionales han participado en esta edición para presentar tecnologías y metodologías destinadas a utilizar datos de forma segura. El programa también ha incluido debates sobre los retos que plantea la protección de la información en un contexto marcado por el crecimiento de la inteligencia artificial y el tratamiento de grandes volúmenes de datos.
Los grupos de investigación FQM391 COAMODEL, de la Universidad de Cádiz, y CRISES, de la Universidad Rovira i Virgili, han coorganizado el encuentro. La serie de congresos Privacy in Statistical Databases comenzó en 2004 como un espacio de intercambio entre especialistas de diferentes disciplinas vinculadas al tratamiento y la seguridad de la información.
En sus sucesivas ediciones, el foro ha integrado trabajos procedentes de ámbitos como la estadística oficial, la informática, la inteligencia artificial, la ciberseguridad y la protección de datos. Esa combinación de disciplinas ha vuelto a estar presente en la cita celebrada en la capital gaditana.
Los trabajos aceptados en PSD 2026 han analizado modelos formales de privacidad, técnicas para proteger microdatos y sistemas de protección de tablas estadísticas. También se han presentado investigaciones sobre la evaluación del riesgo de divulgación, la generación de datos sintéticos y la relación entre el aprendizaje automático y la privacidad.
El programa se ha completado con distintos casos de estudio aplicados. Las investigaciones expuestas examinan cómo aprovechar la información para la toma de decisiones, el desarrollo científico o el entrenamiento de sistemas de inteligencia artificial sin comprometer la privacidad de las personas y entidades cuyos datos son tratados.
La organización sitúa precisamente en el equilibrio entre utilidad y privacidad uno de los principales desafíos de la sociedad digital. Esta cuestión afecta, según expone, a administraciones públicas, empresas, centros de investigación y otras organizaciones que trabajan con información para desarrollar proyectos científicos, estadísticos o tecnológicos.
Entre las soluciones estudiadas figuran la privacidad diferencial, la anonimización avanzada, el aprendizaje federado y los datos sintéticos. Estas tecnologías buscan hacer compatible el análisis y la explotación de la información con las exigencias legales y éticas vinculadas a su tratamiento.
El debate cobra relevancia ante la publicación de grandes volúmenes de información estadística por parte de las administraciones, el uso empresarial de sistemas de inteligencia artificial entrenados con datos masivos y la demanda ciudadana de mayores garantías sobre la utilización de la información personal. El congreso ha abordado estos procesos desde perspectivas técnicas y estadísticas, junto con la evaluación de sus posibles riesgos de divulgación.